AI Video Promptlarında Sesi Sonradan Düşünmeyi Bıraktım
AI video promptu yazarken uzun süre sadece görüntüyü düşünüyordum.
Kamera nerede duracak?
Karakter ne yapacak?
Işık hangi yönden gelecek?
Arka planda ne olacak?
Ses ise videoyu oluşturduktan sonra çözülecek başka bir iş gibi geliyordu.
Fakat görüntü ve sesi birlikte üretebilen video modellerini kullanmaya başlayınca bu yaklaşımın önemli bir sorunu olduğunu fark ettim:
Ses, sahnenin dışında kalan bir detay değil. Zamanlamanın bir parçası.
Özellikle
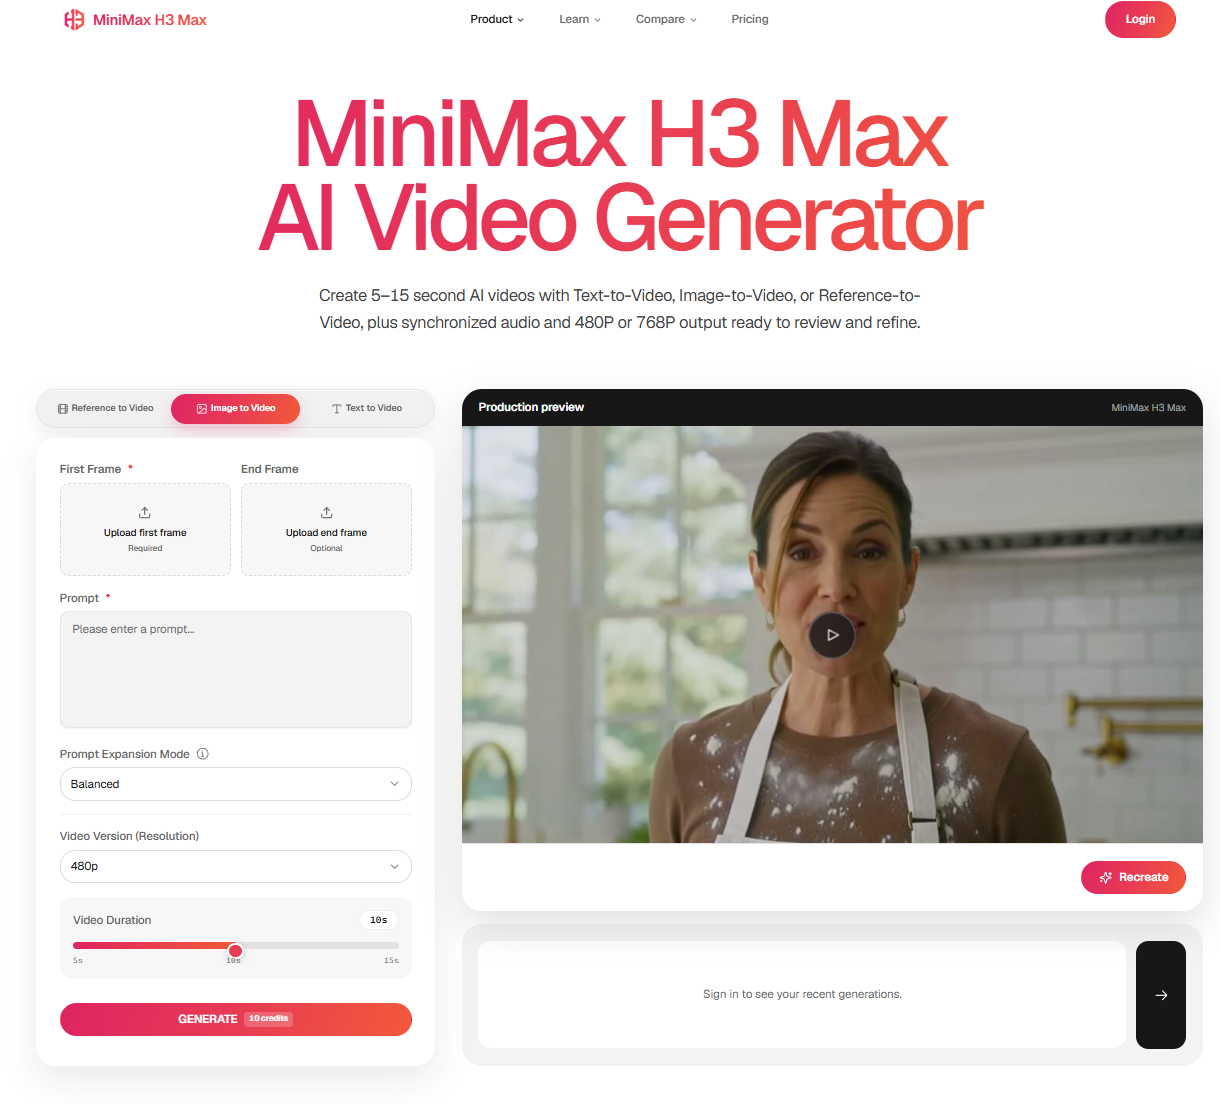
MiniMax H3 Max gibi senkronize ses üretimini video iş akışına dahil eden araçlarda, promptu yalnızca "ne göreceğiz?" sorusuyla kurmak yeterli olmayabiliyor.
Artık prompt hazırlarken ikinci bir soru daha soruyorum:
O anda ne duymamız gerekiyor?
Önce Sessiz Bir Sahne Yazalım
Basit bir örnek düşünelim.
Gece küçük bir kafede çalışan barista son sandalyeyi masanın üzerine koyuyor ve ışıkları kapatıyor.
İlk promptum şöyle olabilir:
A barista places the final chair on a table
inside a small cafe at night.

The camera remains near the entrance.

The barista walks toward the counter
and switches off the lights.

Warm interior lighting.
Quiet cinematic atmosphere.
Görüntü açısından oldukça anlaşılır.
Ama ses açısından neredeyse hiçbir şey söylemiyor.
"Quiet cinematic atmosphere" bir ses planı değil. Sadece genel bir ruh hali tanımlıyor.
Bu yüzden sahnedeki olayları tekrar okuyup hangi hareketlerin gerçekten ses üretmesi gerektiğini işaretliyorum.
Her Görsel Olayın Bir Ses Karşılığı Yok
Sahneyi küçük olaylara bölelim:
1. Sandalye masaya konuyor
2. Barista birkaç adım yürüyor
3. Işık düğmesine basıyor
4. Kafe karanlık oluyor
Bunların ilk üçü için ses düşünülebilir:
Sandalye → hafif ahşap temas sesi
Adımlar → zeminde yumuşak ayak sesleri
Düğme → küçük bir klik
Dördüncü olay ise görsel.
Işıkların sönmesine dramatik bir ses efekti eklemek zorunda değiliz.
Bu ayrım küçük görünüyor fakat
promptun gereksiz seslerle dolmasını engelliyor.
Sesi Listelemek Yerine Zamanlamaya Bağlayın
Şöyle bir bölüm yazmak mümkün:
Audio:
chair sound,
footsteps,
light switch,
cafe ambience
Bu bana ne duyulacağını söylüyor.
Ama
ne zaman duyulacağını yeterince açıklamıyor.
Bunun yerine sesi hareketle birlikte tarif etmeyi tercih ediyorum:
When the chair touches the wooden table,
a short, natural contact sound is heard.

As the barista walks toward the counter,
soft footsteps are audible.

When the light switch is pressed,
a subtle click is heard.

Low cafe room tone remains underneath the scene.
Buradaki temel fikir basit:
Ses, sahneden ayrı bir liste olmaktan çıkıp olayın bir parçası oluyor.
Diyalog Varsa Önce Süresini Düşünün
Diyalog eklenince başka bir problem ortaya çıkıyor.
Örneğin karakterin ışığı kapatmadan önce şunu söylemesini istiyorum:
"That's it for tonight."
Tek cümle.
Bu durumda prompta sadece repliği eklemek yerine sahnedeki yerini de belirtiyorum:
The barista stops behind the counter.

Before switching off the lights, she says calmly:
"That's it for tonight."

After the line ends, she presses the light switch.
Bu yapı bana daha net geliyor:
DUR
↓
KONUŞ
↓
CÜMLE BİTSİN
↓
HAREKET ET
Çünkü aynı anda karakterin yürümesini, konuşmasını, bir nesneyle etkileşime girmesini ve kameranın hareket etmesini istemek sahneyi gereksiz yere karmaşıklaştırabilir.
Sessizlik de Promptun Bir Parçası Olabilir
İlginç şekilde, sesli video promptlarında öğrendiğim en faydalı şeylerden biri daha fazla ses yazmak değil,
nerede ses istemediğimi düşünmek oldu.
Örneğin:
No music.

Only subtle room ambience,
natural footsteps
and the light-switch click.
Bu, özellikle küçük ve gerçekçi sahnelerde yararlı olabilir.
Her videonun müziğe ihtiyacı yok.
Bazen boş bir odanın hafif ortam sesi, sahneye eklenen dramatik müzikten daha anlamlıdır.
Aynı Promptu Katmanlara Ayırıyorum
Şimdi sesli bir video promptunu genellikle dört parçada düşünüyorum:
1. SCENE
2. ACTION
3. CAMERA
4. SOUND
Örneğin:
SCENE:
A small neighborhood cafe at closing time.

ACTION:
A barista places the final chair on a table,
walks behind the counter and switches off the lights.

CAMERA:
Static medium-wide shot from near the entrance.
No camera movement.

SOUND:
Natural room ambience.
A soft wooden contact sound when the chair is placed.
Quiet footsteps as the barista crosses the room.
A subtle click when the light switch is pressed.
No music.
Burada ses bölümü görüntüden bağımsız değil.
Her önemli sesin sahnedeki bir nedeni var.
Ses İçin de Tek Değişken Kuralını Kullanıyorum
Sonuç istediğim gibi değilse bütün promptu değiştirmiyorum.
Örneğin görüntü iyi fakat ortam sesi fazla baskınsa sadece şunu değiştiriyorum:
- Noticeable cafe ambience throughout the scene.
+ Very subtle cafe room tone in the background.
Sonra tekrar deniyorum.
Diyalog çok hızlı geliyorsa sahneyi yeniden tasarlamak yerine önce repliği kısaltıyorum.
- "That's everything finished for tonight. I'll see you tomorrow morning."
+ "That's it for tonight."
Bu şekilde hangi değişikliğin sonucu etkilediğini takip etmek daha kolay oluyor.
Her Sesi Yazmak Gerekmiyor
Burada başka bir tuzak var.
Ses kontrolünü keşfettikten sonra prompta mümkün olan her sesi eklemek.
chair sound
footsteps
clothes movement
breathing
coffee machine
refrigerator
street traffic
rain
door vibration
background conversation
music
Tek bir kısa sahne için bunların hepsi gerçekten gerekli mi?
Ben artık şu soruyu kullanıyorum:
Bu sesi kaldırırsam sahnenin anlamı değişiyor mu?
Cevap hayırsa, çoğu zaman prompttan çıkarıyorum.
Daha fazla detay her zaman daha fazla kontrol anlamına gelmiyor.
Basit Bir Şablon
Ses içeren kısa AI videoları için kullandığım başlangıç şablonu şu:
SCENE:
Sahne nerede ve ne zaman geçiyor?

SUBJECT:
Ana karakter veya nesne nedir?

ACTION:
Sahnede gerçekleşen temel olay nedir?

CAMERA:
Tek bir ana kamera davranışı nedir?

DIALOGUE:
Kim, ne zaman, ne söylüyor?

FOLEY:
Hangi hareketlerin duyulabilir bir sesi olmalı?

AMBIENCE:
Mekânın doğal arka plan sesi nedir?

MUSIC:
Gerekli mi? Değilse açıkça belirt.
Her bölümün doldurulması gerekmiyor.
Asıl amaç uzun prompt yazmak değil.
Görüntü ve sesin aynı zaman çizelgesinde gerçekleştiğini unutmamak.
Promptun İçindeki Zamanlama
AI video promptlarını yalnızca görsel talimatlar olarak düşünmek giderek daha az yeterli geliyor.
Görüntü ve sesi birlikte üreten modellerde prompt artık sadece şunu anlatmıyor:
Ne göreceğiz?
Aynı zamanda şunları da tanımlayabiliyor:
- Ne duyacağız?
- Ne zaman duyacağız?
- Hangi hareket sesi oluşturacak?
- Ve nerede sessizlik daha iyi olacak?
Benim için en kullanışlı değişiklik, prompta daha fazla ses kelimesi eklemek olmadı.
Sesleri sahnedeki olaylara bağlamak oldu.
Bir sandalye masaya değiyorsa ses o anda gelir. Bir karakter konuşuyorsa sonraki hareket replik bittikten sonra başlayabilir. Bir ortamın sessiz olması gerekiyorsa müzik eklememek de bilinçli bir karar olabilir.
AI video promptlarında ses tasarımı belki de ayrı bir son aşama değil.
Promptun içindeki zamanlamanın bir parçası.
 SarahWilson